Java 中的集合概述
前言
本文记录了Java中的集合框架,文章中的内容摘录自Java 集合框架 | 菜鸟教程 (runoob.com)、CSDN、博客园等开源网站。
Java 集合体系
Java 集合框架主要包括两种类型的容器,一种是集合(Collection),存储一个元素集合,另一种是图(Map),存储键/值对映射。Collection 接口又有 3 种子类型,List、Set 和 Queue,再下面是一些抽象类,最后是具体实现类,常用的有 ArrayList、LinkedList、HashSet、LinkedHashSet、HashMap、LinkedHashMap 等等。
集合框架是一个用来代表和操纵集合的统一架构。所有的集合框架都包含如下内容:
- 接口:是代表集合的抽象数据类型。例如 Collection、List、Set、Map 等。之所以定义多个接口,是为了以不同的方式操作集合对象
- 实现(类):是集合接口的具体实现。从本质上讲,它们是可重复使用的数据结构,例如:ArrayList、LinkedList、HashSet、HashMap。
- 算法:是实现集合接口的对象里的方法执行的一些有用的计算,例如:搜索和排序。这些算法被称为多态,那是因为相同的方法可以在相似的接口上有着不同的实现。
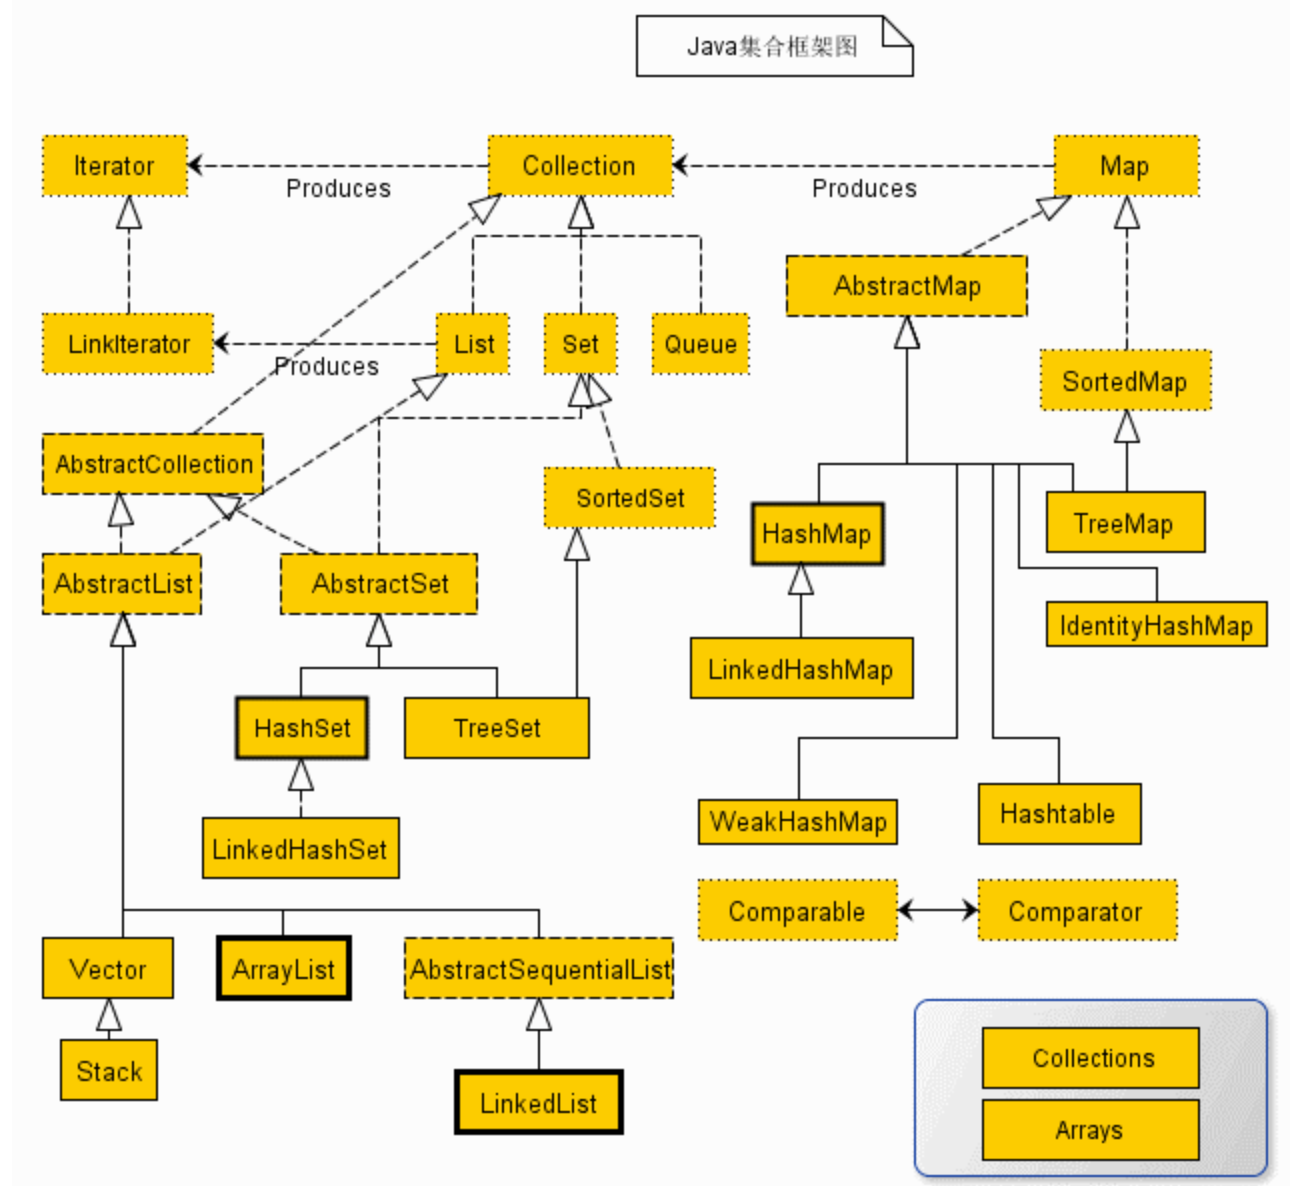
上图堪称集合框架的上帝视角,整个框架的组成部分:
- 集合框架提供了两个遍历接口:
Iterator和ListIterator,其中后者是前者的优化版,支持在任意一个位置进行前后双向遍历。注意图中的Collection应当继承的是Iterable而不是Iterator,后面会解释Iterable和Iterator的区别 - 整个集合框架分为两个门派(类型):
Collection和Map,前者是一个容器,存储一系列的对象;后者是键值对<key,value>,存储一系列的键值对 - 在集合框架体系下,衍生出四种具体的集合类型:
Map、Set、List、Queue Map存储<key,value>键值对,查找元素时通过key查找valueSet内部存储一系列不可重复的对象,且是一个无序集合,对象排列顺序不一List内部存储一系列可重复的对象,是一个有序集合,对象按插入顺序排列Queue是一个队列容器,其特性与List相同,但只能从对头和队尾操作元素- JDK为集合的各种操作提供了两个工具类
Collections和Arrays,之后会讲解工具类的常用方法 - 四种抽象集合类型内部也会衍生出许多具有不同特性的集合类,不同场景下择优使用,没有最佳的集合
集合与数组的区别
- 长度区别:
- 数组固定
- 集合可变
- 内容区别:
- 数组可以是基本类型,也可以是引用类型
- 集合只能是引用类型
- 元素区别:
- 数组只能存储同一种类型
- 集合可以存储不同类型(其实集合一般也是存储同一种类型)
二、Iterator Iterable ListIterator
Iterator 和 Iterable,在第一次看这两个接口时,真以为是一摸一样的,没发现里面有啥不同,存在即合理,它们两个还是有本质区别的。
首先来看 Iterator 接口:
1 | public interface Iterator<E> { |
提供的API接口含义如下:
hasNext():判断集合中是否存在下一个对象next():返回集合中的下一个对象,并将访问指针移动一位remove():删除集合中调用next()方法返回的对象
在早期,遍历集合的方式只有一种,通过 Iterator 迭代器操作:
1 | List<Integer> list = new ArrayList<>(); |
再来看 Iterable 接口:
1 | public interface Iterable<T> { |
可以看到 Iterable 接口里面提供了 Iterator 接口,所以实现了 Iterable 接口的集合依旧可以使用 迭代器 遍历和操作集合中的对象;
而在 JDK1.8 中, Iterable 提供了一个新的方法 forEach() ,它允许使用增强 for 循环遍历对象。
1 | List<Integer> list = new ArrayList<>(); |
我们通过反编译上面这段代码,发现它只是 Java 中的一个 语法糖 ,本质上还是调用 Iterator 去遍历。
1 | Iterator iter = list.iterator(); |
为什么要设计两个接口
Iterable和Iterator,而不是保留其中一个就可以了。简单来说:
Iterator的保留可以让子类去实现自己的迭代器,而Iterable接口更加关注与for-each的增强语法。
总结:
Iterator是提供集合操作内部对象的一个迭代器,它可以 遍历 、移除 对象,且只能够 单向移动-
Iterable是对Iterator的封装,在JDK 1.8时,实现了Iterable接口的结合可以使用 增强 for 循环 遍历集合对象,我们通过 反编译 后发现底层还是使用Iterator迭代器进行遍历
等等,这一章还没完,还有一个 ListIterator。它继承 Iterator 接口,在遍历 List 集合时可以从 任意索引下标 开始遍历,而且支持 双向遍历
ListIterator 存在于 List 集合之中,通过调用方法可以返回 起始下标 为 index 的迭代器:
1 | List<Integer> list = new ArrayList<>(); |
ListIterator 中有几个重要方法,大多数方法与 Iterator 中定义的含义相同,但是 Iterator 强大的地方是可以在 任意一个下标位置 返回该迭代器,且可以实现 双向遍历。
1 | public interface ListIterator<E> extends Iterator<E> { |
Map 和 Collection 接口

Map 接口定义了存储的数据结构是 <key,value> 形式,根据 key 映射到 value,一个 key 对应一个 value,所以 key 不可重复,而 value 可重复。
在 Map 接口下会将存储的方式细分为不同的种类:
SortedMap接口:该接口映射可以对<key,value>按照自己的规则进行 排序,具体实现有 TreeMapAbstractMap类:它为子类提供好一些 通用的API实现,所有的具体 Map 如HashMap都会继承它
而 Collection 接口提供了所有集合的 通用方法(注意这里不包括 Map):
- 添加方法:
add(E e)/addAll(Collection<? extends E> c) - 删除方法:
remove(Object o)/removeAll(Collection<?> c) - 查找方法:
contains(Object o)/containsAll(Collection<?> c) - 查询集合自身信息;
size()/isEmpty() - ···
在 Collection 接口下,同样会将集合细分为不同的种类:
Set接口:一个不允许存储重复元素的无序集合,具体实现有HashSet/TreeSet···List接口:一个可存储重复元素的有序集合,具体实现有ArrayList/LinkedList···Queue接口:一个可存储重复元素的队列,具体实现有PriorityQueue/ArrayDeque···
Map 集合体系详解
Map 接口时由 <key,value> 组成的集合,由 key 映射到唯一的 value,所以 Map 不能包含重复的 key ,每个键至多映射一个值。下图是整个 Map 集合体系的主要组成部分:

HashMap
HashMap 是一个 最通用的 利用哈希表存储元素的集合,将元素放入 HashMap 时,将 key 的哈希值转换为数组的 索引 下标 确定存放位置,查找时,根据 key 的哈希地址转换成数组的 索引 下标 确定查找位置。
HashMap 底层是用数组 + 链表 + 红黑树这三种数据结构实现,它是 非线程安全 的集合。

发送哈希冲突时,HashMap 的解决方法是将相同映射地址的元素连成一条 链表,如果链表的长度大于 8 时,且数组的长度大于 64 则会转换成 红黑树 数据结构。
关于 HashMap 的简要总结:
- 它是集合中最常用的
Map集合类型,底层由数组 + 链表 + 红黑树组成 - HashMap 不是线程安全的
- 插入元素时,通过计算元素的
哈希值,通过 哈希映射函数 转换为数组下标;查找元素时,同样通过哈希映射函数得到数组下标定位元素的位置
LinkedHashMap
LinkedHashMap 可以看作是 HashMap 和 LinkedList 的结合:它在 HashMap 的基础上添加了一条双向链表,默认 存储各个元素的插入顺序,但由于这条双向链表,使得 LinkedHashMap 可以实现 LRU 缓存淘汰策略,因为我们可以设置这条双向链表按照 元素的访问次序 进行排序

LinkedHashMap 是 HashMap 的子类,所以它具备 HashMap 的所有特点,其次,它在 HashMap 的基础上维护了一条 双向链表,该链表存储了 所有元素,默认 元素的顺序与插入顺序 一致。若 accessOrder 属性为 true ,则遍历顺序按元素的访问次序进行排序。
1 | // 头节点 |
利用 LinkedHashMap 可以实现 LRU 缓存淘汰策略,因为它提供了一个方法:
1 | protected boolean removeEldestEntry(Map.Entry<K,V> eldest) { |
该方法可以移除 最靠近链表头部 的一个节点,而在 get() 方法中可以看到下面这段代码,起作用是挪动节点的位置:
1 | if (accessOrder){ |
只要调用了 get() 且 accessOrder = true,则会将该节点更新到链表 尾部,具体的逻辑在 afterNodeAccess() 中,感兴趣可翻看源码,这里不再展开:
如果现在要实现一个 LRU 缓存策略,则需要做两件事:
- 指定
accessOrder = true可以设定链表按照访问顺序排列,通过提供的构造器可以设定accessOrder
1 | public LinkedHashMap(int initialCapacity,float loadFactor,boolean accessOrder) { |
- 重写
removeEldestEntry()方法,内部定义逻辑,通常是判断容量是否达到上限,若是则执行淘汰。
-关于 LinkedHashMap 主要介绍两点:
- 它底层维护了一条
双向链表,因为继承了 HashMap,所以它也不是线程安全的 - LinkedHashMap 可实现
LRU缓存淘汰策略,其原理是通过设置accessOrder为true并重写removeEldestEntry方法定义淘汰元素时需满足的条件
TreeMap
TreeMap 的底层实现是红黑树!
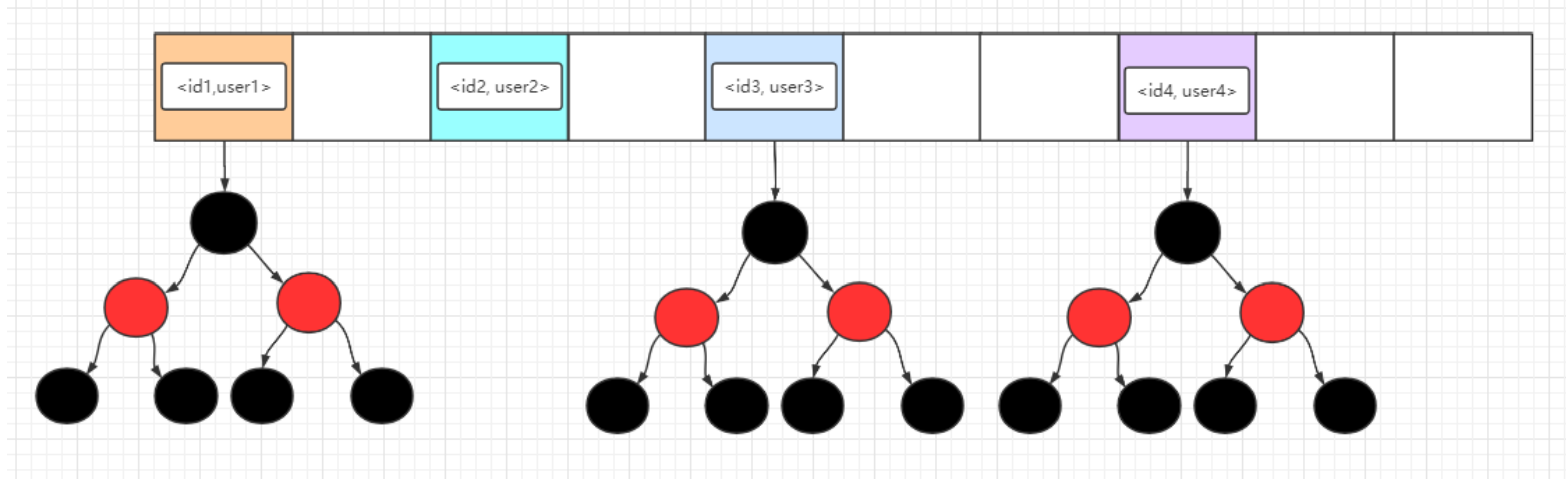
TreeMap 是 SortedMap 的子类,所以它具有 排序 功能。它是基于 红黑树 数据结构实现的,每一个键值对 <key,value> 都是一个节点,默认情况下按照 key 自然排序,另一种是可以通过传入定制的 Comparator 进行自定义规则排序
图中红黑树的每一个节点都是一个 Entry ,在这里为了图片的简洁性,就不标明 key 和 value 了,注意这些元素都是已经按照 key 排好序了,整个数据结构都是保持着 有序 的状态!
关于 自然 排序与 定制 排序:
- 自然排序:要求
key必须实现Comparable接口。
由于 Integer 类实现了 Comparable 接口,按照自然排序规则是按照 key 从小到大排序。
1 | TreeMap<Integer,String> treeMap = new TreeMap<>(); |
- 定制排序:在初始化 TreeMap 时传入新的
Comparator,不要求key实现 Comparable 接口
1 | TreeMap<Integer,String> treeMap = new TreeMap<>((o1,o2) -> Integer.compare(o2,o1)); |
通过传入新的 Comparator 比较器,可以覆盖默认的排序规则,上面的代码按照 key 降序排序,在实际应用中还可以按照其它规则自定义排序。
compare() 方法的返回值有三种,分别是:0,-1,+1
(1)如果返回 0 ,代表两个元素相等,不需要调换顺序
(2)如果返回 +1 ,代表前面的元素需要与后面的元素调换位置
(3)如果返回 -1 ,代表前面的元素不需要与后面的元素调换位置
而何时返回 +1 和 -1,则由我们自己去定义,JDK默认是按照 自然排序,而我们可以根据 key 的不同去定义降序还是升序排序。
关于 TreeMap 主要介绍了两点:
- 它底层是由
红黑树这种数据结构实现的,所以操作的时间复杂度恒为0(logN) - TreeMap 可以对
key进行自然排序或者自定义排序,自定义排序时需要传入Comparator,而自然排序要求key实现了Comparable接口 - TreeMap 不是线程安全的。
WeakHashMap
WeakHashMap 日常开发中比较少见,它是基于普通的 Map 实现的,而里面 Entry 中的键在每一次的 垃圾回收 都会被清除掉,所以非常适合用于 短暂访问、仅访问一次 的元素,缓存在 WeakHashMap 中,并尽早地把它回收掉。
当 Entry 被 GC 时,WeakHashMap 是如何感知到某个元素被回收的呢?
在 WeakHashMap 内部维护了一个引用队列 queue
1 | private final ReferenceQueue<Object> queue = new ReferenceQueue<>(); |
这个 queue 里包含了所有被 GC 掉的键,当JVM开启 GC 后,如果回收掉 WeakHashMap 中的 key,会将 key 放入 queue 中,在 expungeStaleEntries() 中遍历 queue,把 queue 中的所有 key 拿出来,并在 WeakHashMap 中删除掉,以达到 同步。
1 | private void expungeStaleEntries() { |
需要注意的是 WeakHashMap 底层存储的元素的数据结构是 数组 + 链表,没有红黑树哦,可以换一个角度想,如果还有红黑树,那干脆直接继承 HashMap ,然后再扩展不就行了,然而它并没有这样做:
1 | public class WeakHashMap<K,V> extends AbstractMap<K,V> implements Map<K,V> { |
所以,WeakHashMap 的数据结构图如下:

图中被虚线标识的元素将会在下一次访问 WeakHashMap 时删除掉,WeakHashMap 内部会做好一系列的调整工作,所以记住队列的作用就是标志那些已经被 GC 回收掉的元素。
关于 WeakHashMap 需要注意两点:
- 它的键是一种
弱键,放入 WeakHashMap 时,随时会被回收掉,所以不能确保某次访问元素一定存在 - 它依赖普通的
Map进行实现,是一个非线程安全的集合 - WeakHashMap 通常作为 缓存 使用,适用存储那些
只需访问一次、或只需保存短暂时间的键值对
HashTable
HashTable 底层的存储结构是 数组 + 链表,而它是一个 线程安全 的集合,但是因为这个线程安全,它就被淘汰掉了。
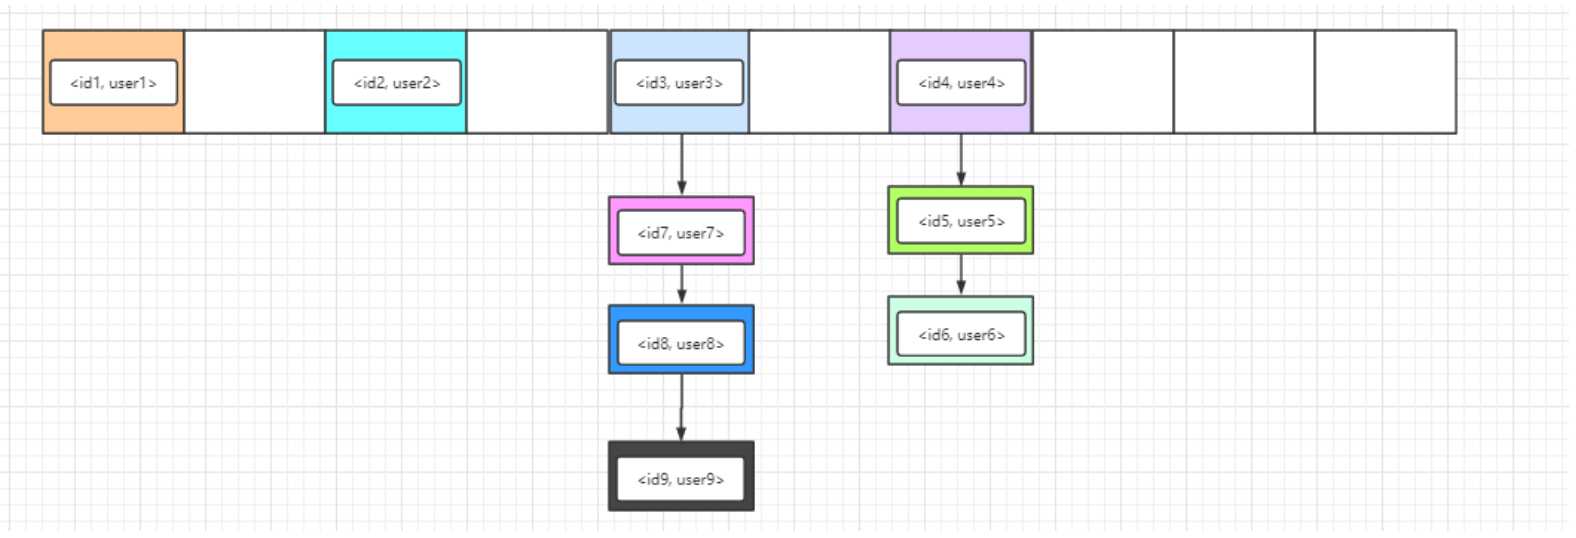
这幅图是否有点眼熟呢哈哈哈,其实本质上就是 WeakHashMap 的底层存储结构。那么为什么 WeakHashMap 不继承 HashTable 呢?HashTable 的
性能在并发环境下是非常差的,在非并发环境下可以用HashMap更优。
HashTable 本质上是 HashMap 的前辈,它被淘汰的原因也主要因为两个字:性能
HashTable 是一个 线程安全 的Map,它所有的方法都被加上了 synchronized 关键字,也是因为这个关键字,它注定成为了时代的弃儿。
HashTable 底层采用 数组+链表 存储键值对,由于被弃用,后人也没有对它进行任何改进
HashTable 默认长度为 11,负载因子为 0.75f,即元素个数达到数组长度的 75% 时,会进行一次扩容,每次扩容为原来数组长度的 2 倍
HashTable 所有的操作都是线程安全的。
Collection 集合体系详解

Set 接口
Set 接口继承了 Collection 接口,是一个不包括重复元素的集合,更确切地说,Set 中任意两个元素不会出现 o1.equals(o2),而且 Set 至多 只能存储一个 NULL 值元素,Set 集合的组成部分可以用下面这张图概括:

在 Set 集合体系中,我们需要关注两点:
- 存入 可变元素 时,必须非常小心,因为任意时候元素状态的改变都有可能使得 Set 内部出现两个 相等 的元素,即
o1.equals(o2) = true,所以一般不要更改存入 Set 中的元素,否则将会破坏了equals()的作用! - Set 的最大作用就是判重,在项目中的最大的作用也是 判重!
接下来我们来分析它的实现类和子类:AbstractSet 和 SortedSet
AbstractSet 抽象类
AbstractSet 是一个实现 Set 的一个抽象类,定义在这里的方法可以将所有具体 Set 集合的 相同行为 在这里实现,避免子类包含大量的重复代码
所有的 Set 也应该要有相同的 hashCode() 和 equals() 方法,所以使用抽象类把该方法重写后,子类就无需关心这两个方法。
1 | public abstract class AbstractSet<E> implements Set<E> { |
SortedSet 接口
SortedSet 是一个接口,它在 Set 的基础上扩展了 排序 的行为,所以所有实现它的子类都会拥有排序功能。
1 | public interface SortedSet<E> extends Set<E> { |
HashSet
HashSet 底层是借助 HashMap 实现,我们可以观察它的多个构造方法,本质上都是 new 一个 HashMap
这也是为什么我们先学习 Map 的原因!先学 Map ,再学 Set,有助于理解 Set !
1 | public class HashSet<E> extends AbstractSet<E> implements Set<E>, Cloneable, java.io.Serializable |
我们可以观察 add() 和 remove() 方法是如何将 HashSet 的操作嫁接到 HashMap 上的
1 | private static final Object PRESENT = new Object(); |
我们看到 PRESENT 就是一个 静态常量 :使用 PRESENT 作为 HashMap 的 value 值,使用 HashSet 的开发者只需要 关注 插入的 key,屏蔽 了 HashMap 的 value

上图可以观察到每个 Entry 的 value 都是 PRESENT 空对象,我们就不用理会它了。
HashSet 在 HashMap 基础上实现,所以很多地方可以联系到 HashMap:
- 底层数据结构:HashSet 也是采用
数组 + 链表 + 红黑树实现 - 线程安全性:由于采用 HashMap 实现,而 HashMap 本身线程不安全,在 HashSet 中又没有额外添加同步策略,所以 HashSet 也 线程不安全
- 存入 HashSet 的对象的状态 最好不要发生变化,因为有可能改变状态后,在集合内部出现两个元素
o1.equals(o2) == true,破坏了equals的含义。
LinkedHashSet
LinkedHashSet 的代码很少,不信我给你粘出来:
1 | public class LinkedHashSet<E> |
代码少归少,还是得分析一下,LinkedHashSet 继承了 HashSet,我们跟随到父类 HashSet 的构造方法看看:
1 | HashSet(int initialCapacity, float loadFactor, boolean dummy) { |
发现父类中 map 的实现采用 LinkedHashMap ,这里注意不是 HashMap ,而 LinkedHashMap 底层又采用 HashMap + 双向链表 实现的,所以本质上 LinkedHashSet 还是使用 HashMap 实现的。
LinkedHashSet -> LinkedHashMap -> HashMap + 双向链表

而 LinkedHashMap 是采用 HashMap + 双向链表 实现的,这条双向链表中保存了元素的插入顺序。所以 LinkedHashSet 可以按照元素的插入顺序遍历元素,如果你熟悉 LinkedHashMap ,那么 LinkedHashSet 也就不在话下了。
关于 LinkedHashSet 需要注意的几个地方:
- 它继承于
HashSet,而 HashSet 默认是采用 HashMap 存储数据的,但是 LinkedHashSet 调用父类的构造方法初始化 map 时是 LinkedHashMap 而不是 HashMap - 由于 LinkedHashMap 不是线程安全的,且在 LinkedHashSet 中没有添加额外的同步策略,所以 LinkedHashSet 集合也不是线程安全 的
TreeSet
TreeSet 是基于 TreeMap 的实现,所以存储的元素是有序的,底层的数据结构是 数组 + 红黑树。

而元素的排列顺序有 2 种,和 TreeMap 相同:自然排序和定制排序,常用的构造方法在下面已经展现出来了,TreeSet 默认使用自然排序,如果需要使用定制排序,需要传入 Comparator。
1 | public TreeSet() { |
关于 TreeSet ,有几个值得注意的点:
TreeSet 的所有操作都会转换为对 TreeMap 的操作,TreeMap 采用 红黑树 实现,任意操作的 时间复杂度 为
0(logN)TreeSet 是一个 线程不安全 的集合
TreeSet 常用于对 不重复 的元素 定制排序,如玩家战斗力排行榜
注意:TreeSet 判断元素是否重复的方法是判断 compareTo() 方法是否返回0,而不是调用 hashCode() 和 equals() 方法,如果返回 0 则认为集合内已存在相同的元素,不会再加入到集合当中。
List 接口
List 接口和 Set 接口齐头并进,是我们日常开发过程中接触很多的一种集合类型了。整个 List 集合的组成部分如下图:

List 接口直接继承于 Collection 接口,它定义为可以存储 重复 元素的集合,并且元素按照插入顺序 有序排列,且可以通过 索引访问指定位置的元素。常见的实现有:ArrayList、linkedList、Vector 和 Stack
AbstractList 和 AbstractSequentialList
AbstractList 抽象类实现了 List 接口,其内部实现了所有的 List 都需具备的功能,子类可以专注于实现自己具体的操作逻辑。
1 | // 查找元素 o 第一次出现的位置 |
AbstractSequentialList 抽象类继承了 AbstractList ,在原基础上限制了访问元素的顺序 只能够按照顺序访问,而 不支持随机访问,如果需要满足随机访问的特性,则继承 AbstractList。子类 LinkedList 使用链表实现,所以仅能支持 顺序访问,故继承了 AbstractSequentialList 而不是 AbstractList。
Vector

Vector 在现在已经是一种过时的集合了,包括继承它的 Stack 集合也是如此,它们被淘汰的原因都是因为 性能 低下。
JDK 1.0 时代,ArrayList 还没诞生,大家都是使用 Vector 集合,但由于 Vector 的 每个操作 都被 synchronized 关键字修饰,即使在线程安全的情况下, 仍然 进行着无意义的加锁/释放锁,造成额外的性能开销,做了无用功。
1 | public synchronized boolean add(E e); |
在 JDK 1.2 时,Collection 家族出现了,它提供了大量 高性能、适用于不同场合 的集合,而 Vector 也是其中一员,但由于 Vector 在每个方法上都加了锁,并且需要兼容许多的老项目,很难在这基础上优化 Vector 了,所以渐渐地也就被历史淘汰了。
现在,在 线程安全 的情况下,不要选用 Vector 集合,取而代之的是 ArrayList 集合;在并发环境下,出现了 CopyOnWriteArrayList,Vector 被完全弃用了。
Stack

Stack 是一种 后入先出(LIFO) 型的集合容器,如图所示,大雄 是最后一个进入容器的,top 指针指向大雄,那么弹出元素时,大雄也是第一个被弹出去的。
Stack 继承了 Vector 类,提供了栈顶的压入元素操作(push)和弹出元素(pop),以及查看栈顶元素(peek)等等,但由于继承于 Vector,Stack 也渐渐被淘汰了。
取而代之的是后起之秀 Deque 接口,其实现有 ArrayDeque,该数据结构更加完善,可靠性更好,依靠队列也可以实现 LIFO 的栈操作,所以优先选择 ArrayDeque 实现栈。
1 | Deque<Integer> stact = new ArrayDeque<Integer>(); |
ArrayDeque 的数据结构是:数组 ,并提供 头尾指针下标 对数组元素进行操作。本文也会在接下来的内容中讲到,请接着往下看!
ArrayList
ArrayList 以 数组 作为存储结构,它是 线程不安全 的集合;具有 查询快、在数组中或头部增删慢 的特点,所以它除了线程不安全这一点,其余可以替代 Vector ,而且线程安全的 ArrayList 可以使用 CopyOnWriteArrayList 代替 Vector。

关于 ArrayList 有几个重要的点需要注意:
- 具有 随机访问 特点,访问元素的效率 较高,ArrayList 在 频繁插入、删除 集合元素的场景下效率较
低 - 底层数据结构:ArrayList 底层是使用数组作为存储结构,具有 查找快、增删慢 的特点
- 线程安全性:ArrayList 是 线程不安全 的集合
- ArrayList 首次扩容 后的长度为
10,调用add()时需要将计算容器 的最小容量。可以看到如果数组elementData为空数组,会将最小容量设置为10,之后会将数组长度完成首次扩容到 10。
1 | // new ArrayList 时的默认空数组 |
- 集合从 第二次扩容 开始,数组长度将扩容为原来的
1.5倍,即:newLength = oldLength * 1.5
1 | private void grow(int minCapacity) { |
LinkedList
LinkedList 底层采用 双向链表 数据接口存储元素,由于链表的内存地址 非连续,所以它不具备随机访问的特点,但由于它利用指针连接各个元素,所以插入、删除元素只需要 操作指针,不需要 移动元素,故具有 增删快、查询慢 的特点。它也是一个非线程安全的集合。
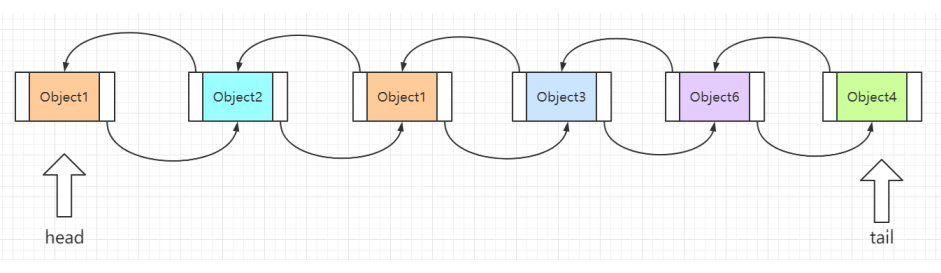
由于以双向链表作为数据结构,它是 线程不安全 的集合;存储的每个节点称为一个 Node ,下图可以看到 Node 中保存了 next 和 prev 指针,item 是该节点的值。在插入和删除时,时间复杂度都保持为 0(1)

关于 LinkedList,除了它是以链表实现的集合外,还有一些特殊的地方需要注意:
优势:LinkedList 底层没有
扩容机制,使用双向链表存储元素,所以插入和删除元素效率较高,适用于频繁操作元素的场景劣势:LinkedList 不具备
随机访问的特点,查找某个元素只能从head或tail指针一个一个比较,所以 查找中间元素是效率很低查找优化:LinkedList 查找某个下标
index的元素时做了优化,若index < (size / 2),则从head往后查找,否则从tail开始往前查找,代码如下所示:1
2
3
4
5
6
7
8
9
10
11
12
13Node<E> node(int index) {
if (index < (size >> 1)) { // 查找的下标处于链表的前半部分则从头开始找
Node<E> x = first;
for (int i = 0; i < index; i++)
x = x.next;
return x;
} else { // 查找的下标处于链表的后半部分则从尾开始找
Node<E> x = last;
for (int i = size - 1; i > index; i--)
x = x.prev;
return x;
}
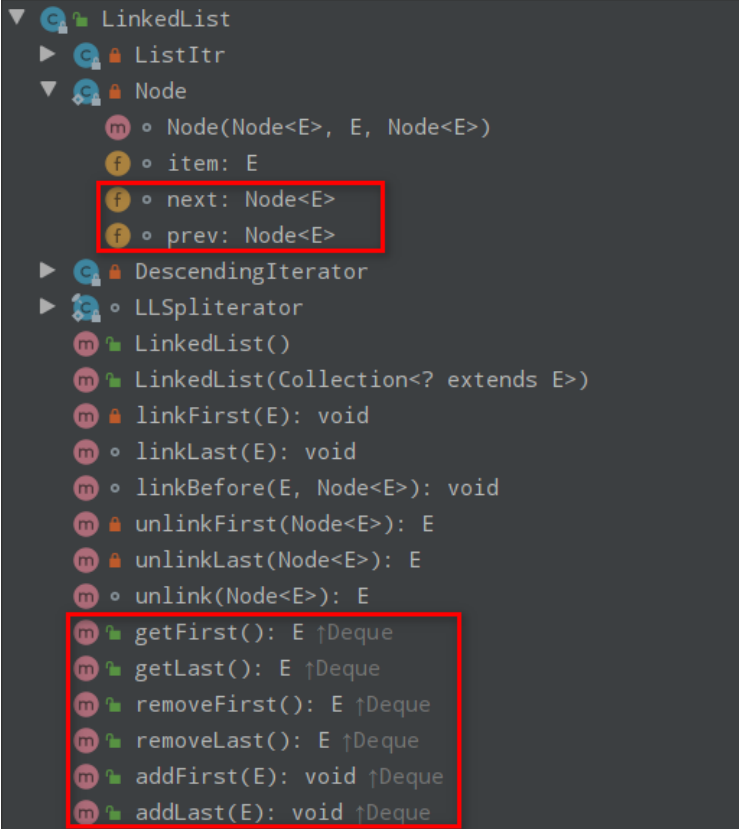
}双端队列:使用双链表实现,并且实现了
Deque接口,使得 LinkedList 可以用作 双端队列 。下图可以看到 Node 是集合中的元素,提供了前驱指针和后继指针,还提供了一系列操作头结点和尾结点的方法,具有双端队列的特性。
Queue 接口
Queue 队列,在 JDK 中两种不同类型的集合实现: 单向队列(AbstractQueue)和 双端队列(Deque)

Queue 中提供了两套增加、删除元素的 API,当插入或删除元素失败时,会有两种不同的失败处理策略。
| 方法及失败策略 | 插入方法 | 删除方法 | 查找方法 |
|---|---|---|---|
| 抛出异常 | add() | remove() | get() |
| 返回失败默认值 | offer() | poll() | peek() |
选区哪种方法的决定因素:插入和删除元素失败时,希望 抛出异常 还是返回 布尔值
add() 和 offer() 对比:
在队列长度大小确定的场景下,队列放满元素后,添加下一个元素时,add() 会抛出 IllegalStateException 异常,而 offer() 会返回 false。
但是他们两个方法在插入 某些不合法的元素 时会抛出三个相同的异常:

remove() 和 poll() 对比:
在 队列为空 的场景下:remove() 会抛出 NoSuchElmentException 异常,而 poll() 则返回 null。
get() 和 peek() 对比:
在队列为空的情况,get() 会抛出 NoSuchElementException 异常,而 peek() 则返回 null。
Deque 接口
Deque 接口的实现非常好理解:从 单向 队列演变为 双向 队列,内部额外提供 双向队列的操作方法 即可:

Deque 接口额外提供了 针对队列的头结点和尾结点 操作的方法,而 插入、删除方法同样也提供了两套不同的失败策略。
除了 add() 和 offer() ,remove() 和 poll() 以外,还有 get() 和 peek() 出现了不同的策略
AbstractQueue 抽象类
AbstractQueue 类中提供了各个 API 的基本实现,主要针对各个不同的处理策略给出基本的方法实现,定义在这里的作用让 子类 根据其 方法规范 (操作失败时抛出异常还是返回默认值)实现具体的业务逻辑。

LinkedList
LinkedList 在上面已经详细解释了,它实现了 Deque 接口,提供了针对头结点和尾结点的操作,并且每个结点都有 前驱 和 后继 指针,具备双向队列的所有特性。
ArrayDeque
使用 数组 实现的双端队列,它是 无界 的双端队列,最小的容量是 8 (JDK1.8)。在 JDK11 之后看到它默认容量已经是 16 了。

ArrayDeque 在日常使用得不多,值得注意的是它与 LinkedList 的对比:LinkedList 采用链表实现双端队列,而 ArrayDeque 使用 数组 实现双端队列。
在文档中作者写到:ArrayDeque 作为栈时比 Stack 性能好,作为队列时比 LinkedList 性能好
由于双端队列 只能在头部和尾部 操作元素,所以删除元素和插入元素的时间复杂度大部分都稳定在 0(1),除非在扩容时会涉及到元素的批量复制操作。但是在大多数情况下,使用它应该指定一个大概的数组长度,避免频繁的扩容。
PriorityQueue
PriorityQueue 基于 优先级堆实现 的优先级队列,而堆是采用 数组 实现的:

文档中的描述告诉我们:该数组中的元素通过传入 Comparator 进行定制排序,如果不传入 Comparator 时,则按照元素本身 自然排序,但要求元素实现了 Comparable 接口,所以 PriorityQueue 不允许存储 NULL 元素。
PriorityQueue 应用场景:元素本身具有优先级,需要按照 优先级处理元素
PriorityQueue 总结:
- PriorityQueue 是基于 优先级堆 实现的优先级队列,而堆是用 数组 维护的
- PriorityQueue 适用于 元素按优先级处理 的业务场景,例如用户在请求人工客服需要排队时,根据用户的 VIP等级 进行
插队处理,等级越高,越先安排客服。
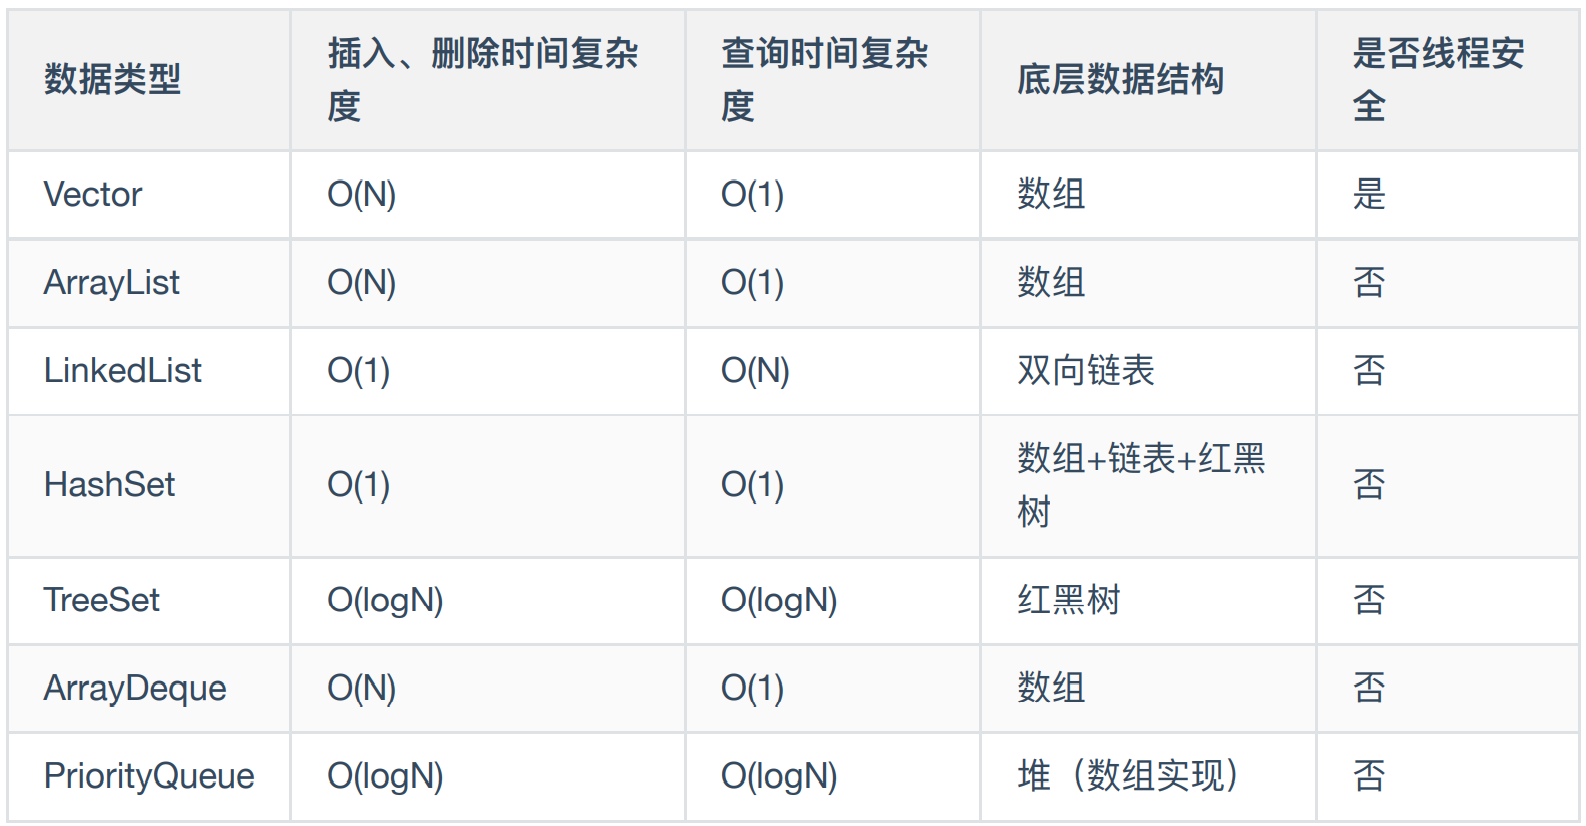
各集合总结:(以 JDK1.8 为例)